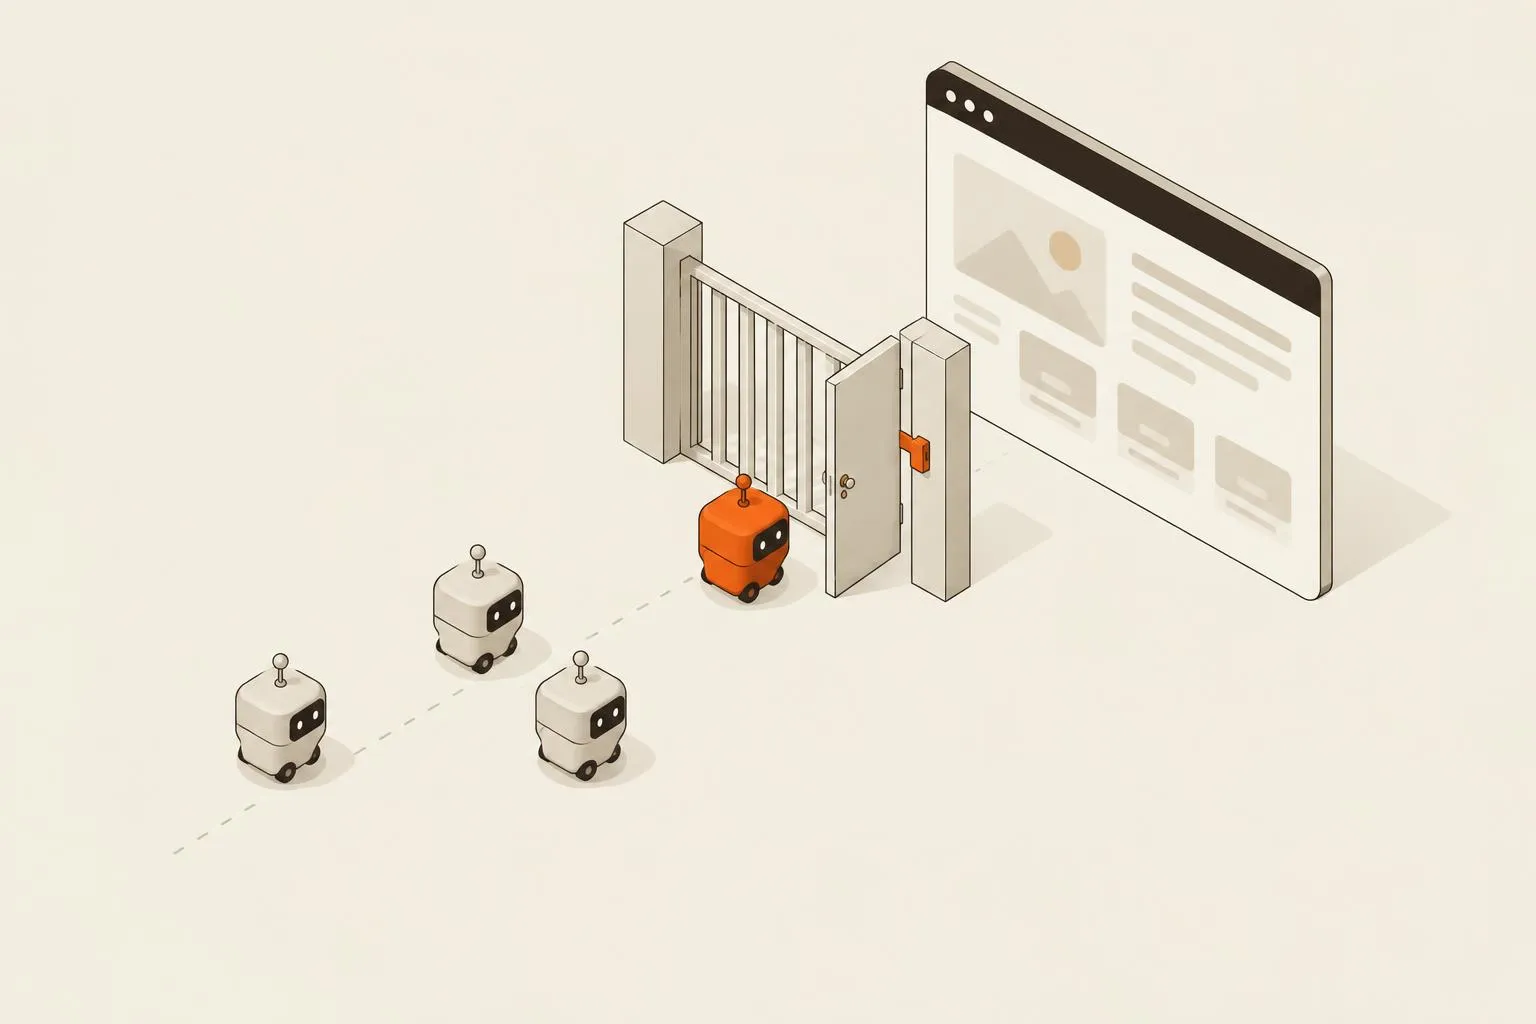
На сайт приходят ИИ-роботы трёх видов: одни собирают тексты для обучения моделей, другие обходят страницы для поиска и готовых ответов нейросети, третьи заходят по запросу конкретного пользователя, который попросил нейросеть открыть страницу. Если бизнес хочет, чтобы Алиса, ChatGPT и другие ИИ-системы его находили и рекомендовали, в robots.txt нужно как минимум не закрывать поисковых роботов и правило YandexAdditional. Роботов для обучения можно закрыть или открыть. Это отдельное решение, и на присутствие в поисковых ответах оно напрямую не влияет.
Дальше по порядку: кто есть кто, готовый пример robots.txt и типичные ошибки, из-за которых сайт выпадает из ответов нейросетей.
Зачем вообще разбираться в ИИ-роботах
Ещё несколько лет назад robots.txt настраивали под пару поисковиков. Теперь в журналах сервера появляются десятки новых имён, а в интернете гуляют шаблоны «закройте сайт от нейросетей». Их копируют целиком и заодно с роботами для обучения закрывают тех, кто отвечает за попадание в ответы.
Итог знаком многим: сайт хорошо стоит в обычном поиске, а нейросеть на вопрос о компании отвечает общими словами или называет конкурентов. Одна строка в robots.txt может перечеркнуть всю работу над текстами, о которой мы писали в статье «Что такое GEO».
Три вида ИИ-роботов
| Вид | Что делает | Что будет, если закрыть |
|---|---|---|
| Для обучения | Собирает тексты, которые могут использоваться для обучения моделей | Ваши тексты не попадут в будущие обучающие данные этой компании |
| Для поиска и ответов | Обходит страницы, чтобы нейросеть находила их и ссылалась в ответах | Сайт может перестать появляться в поисковых ответах этой нейросети |
| По запросу пользователя | Открывает страницу, когда человек попросил нейросеть её прочитать | Нейросеть не сможет открыть вашу страницу по прямой просьбе |
Отдельно стоят правила-переключатели. Сами они сайт не обходят. Это имена, через которые владелец сайта говорит компании: «не используйте мои страницы для таких-то целей». К ним относятся YandexAdditional и Google-Extended.
Кто есть кто: основные user-agent
Яндекс.
- Yandex — общее имя для всех роботов Яндекса в robots.txt; YandexBot — основной индексирующий робот. От индексации зависит всё: ответы Нейро и Поиска с Алисой строятся на поисковом индексе Яндекса.
- YandexAdditional — правило ограничения; отдельного краулера под этим именем нет. Если закрыть для него страницы, их содержимое не будет использоваться в быстрых ответах на базе YandexGPT и в ответах Поиска с Алисой. Подробно о нём рассказано в статье «Как попасть в ответы Алисы и Яндекс Нейро».
OpenAI описывает трёх роботов, и настройки для них независимы:
- GPTBot — собирает данные, которые могут использоваться для обучения генеративных моделей;
- OAI-SearchBot — нужен, чтобы сайты появлялись в результатах поиска ChatGPT;
- ChatGPT-User — заходит на страницу, когда пользователь ChatGPT сам попросил её открыть. OpenAI оговаривает, что для таких действий по запросу пользователя правила robots.txt могут не применяться; актуальную формулировку проверяйте в документации.
Anthropic — ClaudeBot: робот, который собирает данные для моделей компании.
Perplexity — PerplexityBot: обходит страницы, чтобы показывать сайты и ссылки в ответах Perplexity.
Google — Google-Extended: управляющий токен, своего робота за ним тоже нет. Страницы по-прежнему обходит Googlebot, а через Google-Extended можно запретить использовать их для обучения и работы моделей Gemini. На присутствие в обычном поиске Google он не влияет.
DeepSeek — в журналах встречается user-agent DeepSeekBot. Подробной публичной документации о нём мало, поэтому решение по нему принимайте так же, как по роботам для обучения, и следите за обновлениями.
GigaChat — публичного отдельного робота с описанным user-agent нет, поэтому прописать для него правило нельзя.
Пример robots.txt для бизнеса, который хочет быть в ответах нейросетей
Условный пример для интернет-магазина. Задача: служебные разделы закрыты для всех, поисковые и пользовательские ИИ-роботы допущены к каталогу и условиям, обучение моделей остаётся на усмотрение владельца.
# Все роботы: закрыть служебные разделы
User-agent: *
Disallow: /admin/
Disallow: /cart/
Disallow: /search/

# Яндекс: у отдельной группы свои правила,
# поэтому служебные разделы дублируем
User-agent: Yandex
Disallow: /admin/
Disallow: /cart/
Disallow: /search/

# Ответы на базе YandexGPT и Поиска с Алисой — разрешены
User-agent: YandexAdditional
Allow: /

# Поиск и ответы ChatGPT — разрешены
User-agent: OAI-SearchBot
Disallow: /admin/
Disallow: /cart/

User-agent: ChatGPT-User
Disallow: /admin/
Disallow: /cart/

# Поиск Perplexity — разрешён
User-agent: PerplexityBot
Disallow: /admin/
Disallow: /cart/

# Обучение моделей — пример запрета, решение за вами
User-agent: GPTBot
Disallow: /

User-agent: ClaudeBot
Disallow: /

User-agent: Google-Extended
Disallow: /

Sitemap: https://example.ru/sitemap.xml
Обратите внимание на дублирование служебных разделов. Робот выполняет только ту группу, которая обращена к нему по имени, а общую группу со звёздочкой в этом случае не читает. Если вы хотите, чтобы ваши тексты использовались и для обучения моделей, просто уберите блоки с Disallow: / для GPTBot, ClaudeBot и Google-Extended.
Ошибки в robots.txt, которые закрывают сайт от ИИ
- Случайно закрыли всё.
Disallow: /в группе со звёздочкой остался после тестовой версии сайта или редизайна. Сайт выпадает и из поиска, и из ответов нейросетей. - Disallow для YandexAdditional «за компанию». Строку скопировали из шаблона «закрыть сайт от ИИ» вместе с запретами для других роботов. В обычном поиске Яндекса сайт есть, а в ответах Нейро и Алисы его содержимое не используется.
- Отдельная группа без дублирования. По справке Яндекса, если в robots.txt есть группа для конкретного робота Яндекса, группы Yandex и
*этим роботом не используются. Создали группу «YandexBot» с одним правилом — и все остальные запреты для него исчезли. Так же устроены группы и у других роботов. - Закрыли поиск, хотели закрыть обучение. Запретили OAI-SearchBot вместо GPTBot или оба сразу, не разобравшись в назначении.
- Ждут от robots.txt защиты. Файл работает как просьба к добросовестным роботам, замком он не служит. Закрытая в robots.txt страница может быть известна по внешним ссылкам, а недобросовестный бот может правила проигнорировать.
- Важное лежит в закрытых разделах. Условия доставки в
/help/, а/help/закрыт целиком. Проверьте, что страницы с ценами, условиями и контактами открыты.
Не только robots.txt: защита от ботов и метатеги
Бывает, что robots.txt настроен идеально, а ИИ-роботы всё равно не видят сайт. Частые причины:
- Защита от ботов у хостинга или сети доставки контента. Многие сервисы умеют блокировать «подозрительных» роботов одной галочкой, в том числе ИИ-роботов. Сайт в этом случае отвечает им ошибкой или страницей проверки, и robots.txt до них даже не доходит. Проверьте настройки защиты и список заблокированных роботов.
- Метатег noindex и заголовок X-Robots-Tag. Если страница закрыта от индексации, её не будет в поисковом индексе, а значит, и в ответах, которые на нём строятся (например, в Нейро).
- Содержимое только в скриптах. Робот получил страницу, но цены и описания подгружаются скриптом после загрузки. Многие роботы скрипты не выполняют и видят пустую карточку.
Пример: как одна строка убрала магазин из ответов
Условный пример. Интернет-магазин чая в Самаре после обновления сайта заметил, что Алиса на вопрос о магазине отвечает общими словами, хотя в обычном поиске Яндекса магазин на месте. Разработчик при переезде взял robots.txt из шаблона «защита от нейросетей», где среди прочего было:
User-agent: YandexAdditional
Disallow: /
Индексацию строка не затронула, поэтому в Вебмастере всё выглядело нормально. Но содержимое страниц перестало использоваться в генеративных ответах. После того как правило убрали, а заодно открыли OAI-SearchBot, у нейросетей снова появилось, на что опереться. Попадёт ли магазин в конкретный ответ, решает система, но препятствие исчезло.
Как проверить по логам сервера
robots.txt говорит, что вы разрешили. Журналы сервера показывают, кто на самом деле приходит.
- Получите журналы доступа у хостинга или администратора. Обычно это файл access.log, где у каждого запроса есть адрес страницы, код ответа и user-agent.
- Найдите ИИ-роботов по имени. Ищите в поле user-agent: YandexBot, GPTBot, OAI-SearchBot, ChatGPT-User, ClaudeBot, PerplexityBot, DeepSeekBot.
- Посмотрите коды ответов. Если роботу массово отдаются 403 или 5xx, его может блокировать защита от ботов или сетевой экран. Такая причина невидимости с robots.txt никак не связана.
- Проверьте, какие страницы читают. Доходят ли роботы до карточек товаров, цен и условий или упираются в главную.
- Не верьте user-agent на слово. Его легко подделать. OpenAI публикует диапазоны адресов своих роботов, а Яндекс описывает проверку своих роботов через обратный DNS-запрос.
Отдельно проверьте сам robots.txt в Яндекс Вебмастере: там есть инструмент анализа файла, который покажет, разрешена ли конкретная страница. А что нейросети в итоге отвечают о компании, проверяйте по методике из статьи «Как проверить, что нейросети говорят о вашей компании».
Открыть или закрыть: как принять решение
Простое правило для бизнеса, которому важны клиенты из нейросетей:
- поисковые роботы и правила для ответов (YandexBot, YandexAdditional, OAI-SearchBot, PerplexityBot) держите открытыми для публичных страниц;
- роботы по запросу пользователя — тоже открыты: человек уже интересуется вами;
- роботы для обучения — решайте сознательно. Если тексты — ваш продукт, например платные статьи, их разумно закрыть. Если это описание товаров и услуг, которое вы и так хотите донести до всех, закрытие мало что защищает.
И запрет в robots.txt не единственная мера. Платные материалы надёжнее защищать авторизацией, а не строчкой в robots.txt.
Если robots.txt в порядке, а нейросети вас всё равно не видят
Тогда причину стоит искать шире: в защите от ботов, метатегах, скриптах, в том, как устроены сами страницы. В тариф GEO-оптимизации SetSearch входит машиночитаемая версия сайта или GEO-агент на основе MCP. Вариант подбирается под сайт, интеграцию выполняет команда SetSearch. Она же следит за трендами ИИ-поиска, проверяет читаемость сайта для нейросетей и регулярно обновляет решение под их новые требования.
Начать можно с проверки на собственном сайте. Бесплатный GEO-аудит покажет, что нейросети говорят о компании сейчас и что мешает им прочитать ваши страницы.
Памятка перед тем, как трогать robots.txt
- ИИ-роботы бывают трёх видов: для обучения, для поиска и ответов, по запросу пользователя.
- YandexAdditional и Google-Extended сами сайт не обходят. Это правила-переключатели. YandexAdditional не закрывайте «за компанию», если хотите быть в ответах Нейро и Алисы.
- Поисковых роботов держите открытыми для публичных страниц.
- Роботов для обучения закрывайте осознанно: на поисковые ответы это напрямую не влияет.
- Отдельная группа для робота отменяет для него общие правила, поэтому запреты нужно продублировать.
- Результат проверяйте по журналам сервера и в Яндекс Вебмастере. Текст robots.txt показывает только намерения.
Источники
- OpenAI: роботы и user-agent (GPTBot, OAI-SearchBot, ChatGPT-User) — назначение роботов и примеры правил robots.txt
- Яндекс: директива User-agent и роботы Яндекса — список роботов, YandexAdditional и порядок применения групп
- Яндекс Вебмастер — анализ robots.txt и проверка индексации
Частые вопросы
Если закрыть GPTBot в robots.txt, сайт пропадёт из ChatGPT?
Не обязательно. GPTBot по описанию OpenAI собирает данные, которые могут использоваться для обучения моделей, а за поиск в ChatGPT отвечает другой робот — OAI-SearchBot. Правила для них задаются отдельно, поэтому можно запретить одно и разрешить другое.
Как закрыть сайт от нейросетей полностью?
Можно прописать Disallow для каждого известного ИИ-робота и правила ограничения вроде YandexAdditional и Google-Extended. Но полной гарантии robots.txt не даёт: это просьба к добросовестным роботам, а не защита. И закрываясь, вы убираете себя из ответов нейросетей, где вас могли бы рекомендовать.
Есть ли у GigaChat свой робот, которого нужно разрешить?
Публичного отдельного робота GigaChat с описанным user-agent нет. Поэтому специальное правило для него в robots.txt прописать нельзя.
Почему робот Яндекса игнорирует мои правила для всех роботов?
По справке Яндекса, если в robots.txt есть отдельная группа для робота Яндекса, группы Yandex и звёздочка этим роботом не используются. Все нужные запреты придётся продублировать внутри его собственной группы.
Как узнать, какие ИИ-роботы уже заходят на сайт?
Посмотрите журналы доступа веб-сервера и поищите в поле user-agent названия роботов: GPTBot, OAI-SearchBot, ChatGPT-User, ClaudeBot, PerplexityBot, YandexBot. Учтите, что user-agent можно подделать, поэтому для важных выводов проверяйте и адрес, с которого пришёл запрос.